
- Главная
- Искусственный интелект
- Главные причины случайности ответов LLM
Главные причины случайности ответов LLM
Почему одна и та же модель с одним и тем же промптом дает разные ответы? На первый взгляд это похоже на ошибку, но на самом деле так работает любая большая языковая модель. В этом уроке разберём, почему LLM недетерминированы, как параметр temperature управляет разбросом ответов и что это означает для вашей ежедневной работы с ИИ-агентом.
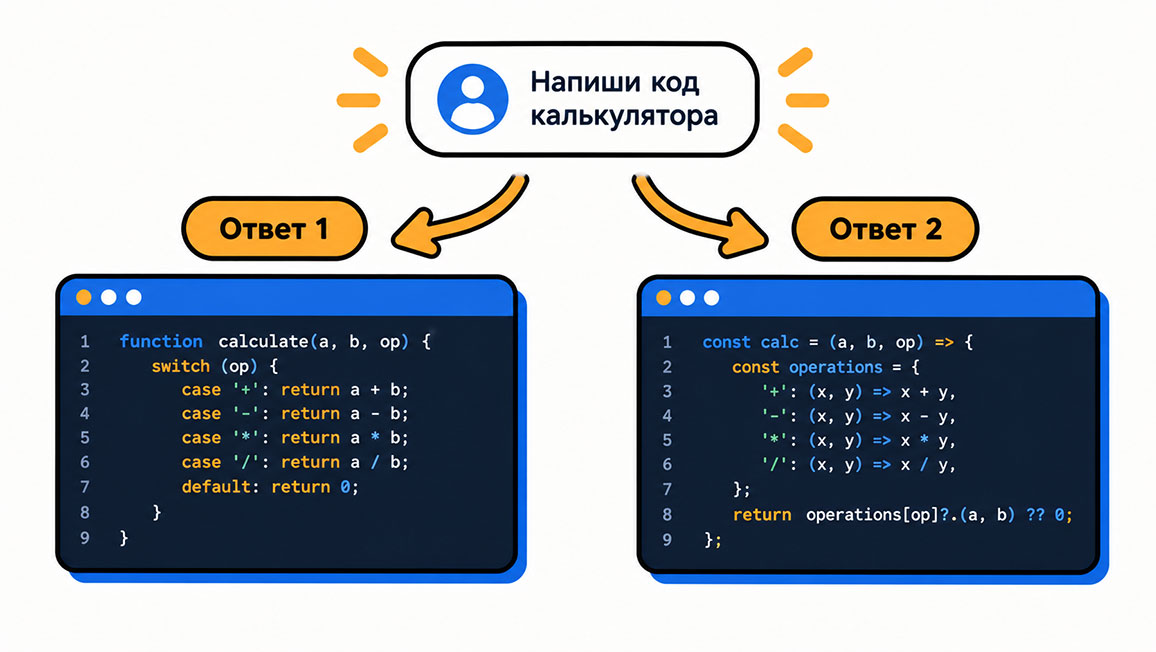
Как модель выбирает ответ
Но она не выбирает единственный «правильный» токен — она строит распределение вероятностей по всему словарю и затем делает выборку из этого распределения.
Посмотрим на упрощённый пример. Модель получила контекст «2 + 2 =». Распределение вероятностей для следующего токена может выглядеть так:
| Токен | Вероятность |
|---|---|
| «4» | 0,85 |
| «четыре» | 0,10 |
| «5» | 0,03 |
| «3» | 0,01 |
| остальные | 0,01 |
Токен «4» — самый вероятный, и чаще всего модель выберет его. Но если процесс выборки допускает случайность, иногда модель «вытянет» «четыре» или даже «5». В большинстве практических случаев разница незаметна, но в длинных цепочках генерации даже малая случайность накапливается и приводит к ощутимо разным результатам.
Из этого следует важный вывод: недетерминированность — не баг и не ошибка реализации, а фундаментальное свойство вероятностной природы модели. Это не «глюк», который можно починить, а характеристика, которую нужно понимать и учитывать.
Параметр temperature
Принцип работы прост.
- Temperature = 0 — модель всегда выбирает самый вероятный токен. Результат становится детерминированным: один и тот же промпт даёт один и тот же ответ. Идеально для кода, фактов, точных инструкций.
- Temperature = 1 — стандартное значение. Модель выбирает токены пропорционально их вероятности. Результат может варьироваться от запуска к запуску.
- Temperature > 1 — распределение искусственно «уплощается». Маловариантные токены получают гораздо больше шансов. Используется для творческих задач, где нужна неожиданность.
Temperature = 0 — это стандартная рекомендация для инженерных задач. Когда вы просите агента написать код, отрефакторить функцию или выполнить миграцию базы данных, вы хотите предсказуемого результата. Нулевая температура обеспечивает повторяемость.
Проверьте настройки своего harness: многие инструменты по умолчанию устанавливают temperature в 0 для инструментальных запросов, но не для «обычных» диалоговых. Если агент每次 ведёт себя по-разному на стандартные просьбы — проверьте, не стоит ли temperature выше нуля на те запросы, где нужна повторяемость.
Важно знать: разные модели по-разному реагируют на одно и то же значение temperature. Для одной модели temperature = 0,3 даёт почти детерминированный результат, для другой — заметный разброс. Конкретные числа — это не абсолютная шкала, а настройка, которую нужно подбирать под конкретную модель.
Источники недетерминированности
Temperature — главный, но не единственный источник недетерминированности. Даже при temperature = 0 результат может варьироваться. Вот почему.
- Аппаратная и численная нестабильность — вычисления с плавающей точкой могут давать микроскопически разные результаты на разном оборудовании или при разной загрузке сервера. На практике это редко меняет ответ, но в теории возможно.
- Параметр top-p — альтернативный механизм выборки: модель ограничивает набор кандидатов суммой вероятностей (например, top-p = 0,9 означает «выбирай из токенов, на которые приходится 90% вероятности»). В комбинации с temperature это даёт дополнительную вариативность.
- Обновления модели — провайдер может незаметно обновить модель, и та же версия с тем же temperature начнёт выдавать slightly другие ответы. Версионирование моделей — отдельная тема, к которой мы вернёмся.
- Порядок токенов в контексте — контекст большого размера может быть обработан с разным внутренним порядком внимания (attention) на разных серверах, что влияет на итоговое распределение.
На практике эти источники дают о себе знать редко. Основная недетерминированность, которую вы видите в повседневной работе, — это результат ненулевого temperature.
Почему это важно для работы с агентом
Разные решения одной задачи. Вы просите агента отрефакторить функцию. В первом запуске он переименовывает переменные, во втором — меняет структуру кода, в третьем — оставляет как есть и предлагает написать тесты. Все три решения могут быть разумными, но ни одно не гарантировано.
Разный порядок действий. Агент, который выполняет многошаговую задачу, в каждом запуске может выбирать разную последовательность шагов. Это не проблема, пока все пути ведут к цели, но может сбивать с толку при отладке.
Нестабильные результаты при тестировании. Если вы проверяете работу агента, запуская один и тот же запрос несколько раз, вы получите разные результаты. Тестирование «на воспроизводимость» для агентов — отдельная дисциплина.
Самый практичный приём: если агент сделал что-то неожиданное или странное — дайте ту же команду ещё раз. Иногда достаточно второго запуска при той же конфигурации, чтобы получить нормальный результат. Это не «гадание», а осознанное использование вероятностной природы модели.
Как смягчить недетерминированность
Полностью убрать недетерминированность нельзя — это свойство LLM. Но её можно снизить до уровня, где она перестаёт мешать.
Temperature = 0. Для всех инженерных запросов — код, команды, фактические вопросы — используйте нулевую температуру. Это единственный способ гарантировать повторяемость.
Чёткие инструкции. Чем более конкретный промпт, тем меньше пространства для интерпретации. «Переименуй функцию getData в fetchUserData» даст гораздо более стабильный результат, чем «улучши именование в коде».
Few-shot примеры. Если агент должен следовать определённому формату или стилю, дайте 1-3 примера в промпте. Примеры смещают распределение вероятностей в нужную сторону и снижают разброс.
Разбиение на мелкие шаги. Чем короче каждый отдельный запрос к модели, тем меньше вероятность, что на выходе «накопится» отклонение. Много коротких шагов с temperature = 0 работают предсказуемее, чем один длинный промпт.
Проверка результатов. Не доверяйте однократному ответу агента, особенно если задача сложная или дорогая. Встройте проверку: попросите агента объяснить своё решение, запустить тесты, показать diff. Если результат неудовлетворительный — повторите запрос.
Недетерминированность ≠ произвольность
Результаты распределены вокруг некоторого «центра тяжести» — разумного ответа, который модель считает наиболее вероятным. Разброс — это вариации на тему этого центра, а не случайные блуждания.
На практике это означает, что:
- Результаты редко бывают полностью неожиданными — они находятся в предсказуемом диапазоне.
- Повторные запуски — не баг, а фича: вы можете «увидеть» несколько вариантов решения одной задачи и выбрать лучший.
- С опытом вы учитесь предсказывать, какие части ответа стабильны, а какие варьируются, и быстрее отсеиваете неудачные варианты.
Недетерминированность — это не хаос, а «поле возможностей», из которого вы выбираете подходящий результат. Отношение к этому свойству как к инструменту, а не как к помехе — признак зрелого пользователя ИИ-агента.
Типичные ошибки
- Считать недетерминированность багом модели — это не ошибка, а фундаментальное свойство вероятностной генерации.
- Пытаться получить идеально воспроизводимый результат при высокой temperature — низкая температура решает проблему, а не повторные попытки.
- Не учитывать недетерминированность при тестировании агента — если тест запускается один раз, его результат ничего не гарантирует.
- Доверять первому ответу агента в сложной задаче — первый запуск может быть удачным, но может быть и крайним значением распределения.
- Менять модель или harness при нестабильных результатах, когда достаточно снизить temperature — самый частый и дорогой способ борьбы с не тем источником.
Итоги
Недетерминированность — фундаментальное свойство LLM, вытекающее из вероятностной природы генерации токенов. Параметр temperature — главный инструмент управления этим свойством: при temperature = 0 результат становится детерминированным. Для стабильной работы с агентом используйте низкую temperature, чёткие инструкции, few-shot примеры и проверку результатов. Относитесь к недетерминированности не как к помехе, а как к инструменту, который даёт вам выбор из нескольких вариантов.
В следующем уроке разберём, что такое «ходы» (turns) и как агент формирует запросы к провайдеру модели — за один turn может быть несколько API-вызовов с разными целями.
Глоссарий
- Недетерминированность — свойство системы выдавать разные результаты при одинаковых входных данных.
- Temperature — параметр модели, управляющий «остротой» распределения вероятностей при выборке токена.
- Top-p — параметр выборки, ограничивающий набор кандидатов суммой вероятностей.
- Токен — минимальная единица текста, которую модель обрабатывает (слово или часть слова).
- Распределение вероятностей — набор вероятностей для всех возможных следующих токенов.
- Выборка (sampling) — процесс выбора конкретного токена из распределения вероятностей.
- Детерминированность — свойство системы давать одинаковый результат при одинаковых входных данных.
- Few-shot — техника промптинга, при которой в запрос включаются 1-3 примера желаемого вывода.
- Промпт — запрос пользователя или агента к модели.
- Seed — число, которое фиксирует генератор случайных чисел для воспроизводимости (поддерживается не всеми моделями).