
- Главная
- Искусственный интелект
- Шаги ИИ-агента: устройство запросов к модели
Шаги ИИ-агента: устройство запросов к модели
Когда агент «думает» и выполняет задачу, за кулисами происходит десятки и сотни обращений к API провайдера модели. Каждый такой вызов — это отдельный запрос с собственным расходом токенов и собственной ценой. В этом уроке разберём, что такое «шаг» (turn) агента, как формируется запрос к провайдеру, как выглядит ответ модели и почему один шаг почти всегда состоит из нескольких обращений к API.
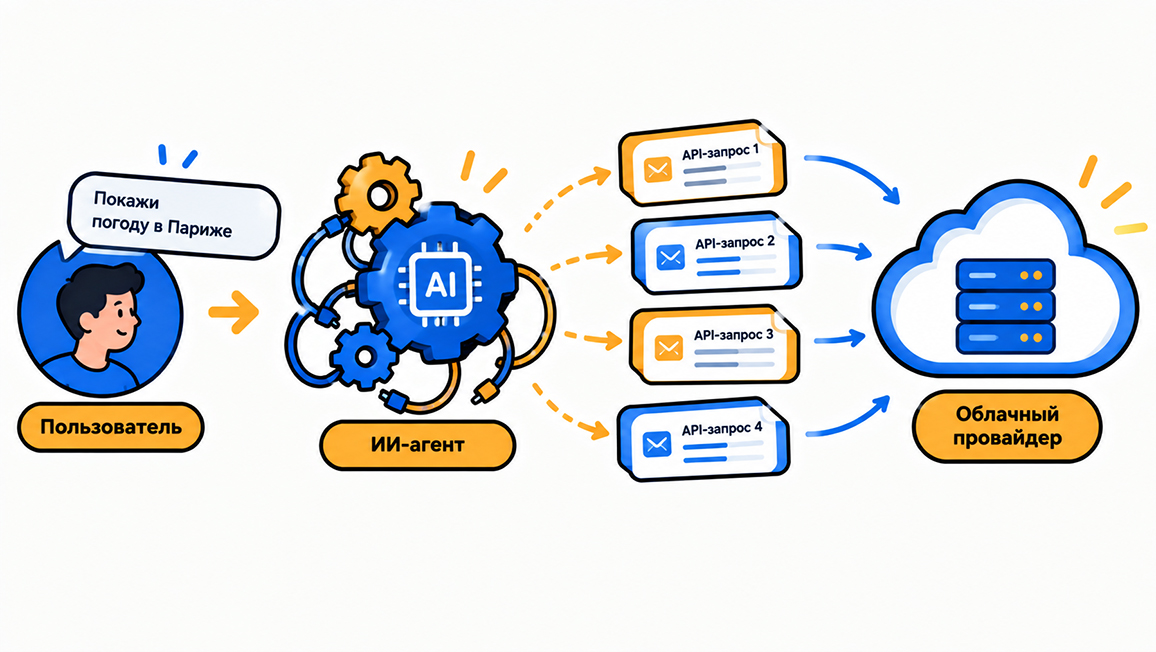
Что такое шаг агента
пользователь → агент → пользователь. Он начинается с того момента, когда вы отправили сообщение агенту, и заканчивается тем моментом, когда агент полностью завершил обработку и готов снова ждать вашего ввода. Всё, что происходит между этими двумя моментами, — это шаг.В разговорном смысле шаг кажется простым: вы написали «почини баг», агент «взял и починил». Но внутри одного шага происходит не одно действие модели, а целая последовательность шагов. Каждый шаг может включать своё обращение к API, и все эти обращения суммируются в общий расход.
Именно здесь начинается разница между «наивным» представлением о работе с ИИ и инженерным.
Наивное представление: один запрос — одна цена.
Инженерное: один запрос от вас может породить десятки вызовов модели, инструментов и повторных запросов внутри одного шага.
Из чего состоит шаг
Рассмотрим каждую.
- Восприятие — агент получает ваше сообщение и собирает контекст: историю сессии, содержимое файлов, вывод предыдущих команд.
- Планирование — агент решает, что делать дальше: какой инструмент вызвать, какой файл прочитать, какую команду выполнить.
- Действие — агент выполняет выбранное действие через инструменты и возвращает результат в контекст.
- Завершение — агент формирует итоговый ответ для вас или передаёт управление обратно.
Фазы «планирование» и «действие» повторяются циклически: агент планирует один шаг, выполняет его, видит результат, снова планирует и так далее. Каждый такой виток — это, как правило, отдельное обращение к модели. Чем сложнее задача, тем больше витков и тем больше запросов к провайдеру внутри одного шага.
Важно понимать: агент сам решает, сколько витков ему нужно. Никакого «жёсткого лимита» нет — есть только контекстное окно модели и ваши настройки разрешений. Поэтому один и тот же запрос у разных агентов или в разных harness-ах может привести к разному числу обращений к API.
Как выглядит API-запрос к провайдеру
Каждый «виток» шага агент оформляет как стандартный HTTP-запрос к API провайдера. Формат запросов унифицирован: огромное число провайдеров поддерживают OpenAI-совместимый интерфейс, поэтому структура ниже знакома практически всем.
{
  "model": "gpt-4o",
  "messages": [
    {"role": "system", "content": "Ты — инженерный ассистент"},
    {"role": "user", "content": "Почини баг в модуле auth"},
    {"role": "assistant", "content": "Сейчас посмотрю код и найду причину"},
    {"role": "user", "content": "Вот содержимое файла auth.ts: ..."}
  ],
  "temperature": 0,
  "tools": [
    {"type": "function", "function": {"name": "read_file", "parameters": {...}}}
  ]
}
Разберём ключевые поля.
- model — идентификатор модели, к которой идёт запрос. Один шаг может обращаться к разным моделям, если так настроен ваш harness (например, лёгкая модель для поиска файлов и тяжёлая для рассуждений).
- messages — вся история сообщений, которую агент передаёт модели. Сюда входит и ваша переписка, и промежуточные результаты инструментов. Именно этот массив определяет размер контекста.
- temperature — параметр выборки, о котором мы говорили в уроке про недетерминированность.
- tools — описания инструментов, доступных модели. Хитрость в том, что описания инструментов (схемы параметров) сами занимают токены и отправляются в каждом запросе.
Ключевой момент: агент не отправляет «только новое слово». Каждый запрос к провайдеру включает всю накопленную историю — весь массив messages от начала шага (и от начала сессии). Именно поэтому один и тот же запрос стоит денег тем больше, чем длиннее сессия.
Как выглядит ответ модели
Ответ модели на запрос — это тоже структурированный JSON. В нём есть выбор сделанных токенов, причина завершения (finish_reason) и, если модель решила воспользоваться инструментом, — описание вызова инструмента (tool call).
{
  "choices": [
    {
      "message": {
        "role": "assistant",
        "content": null,
        "tool_calls": [
          {
            "id": "call_abc123",
            "type": "function",
            "function": {
              "name": "read_file",
              "arguments": "{\"path\": \"src/auth.ts\"}"
            }
          }
        ]
      },
      "finish_reason": "tool_calls"
    }
  ],
  "usage": {
    "prompt_tokens": 4521,
    "completion_tokens": 132,
    "total_tokens": 4653
  }
}
Что здесь важно.
- content может быть null. Если модель решила вызвать инструмент, в content текста нет — вместо него заполняется блок tool_calls. «Мыслей вслух» модель в запросе не показывает: промежуточные рассуждения (если они есть) скрыты в системном поле reasoning.
- finish_reason сообщает, почему завершилась генерация. Значение tool_calls означает «модель хочет вызвать инструмент и ждёт результат». Значение stop — «модель закончила и ответ готова». Именно по finish_reason harness понимает, продолжать ли цикл.
- usage — это счётчик потраченных токенов. prompt_tokens — весь контекст, отправленный на вход; completion_tokens — сгенерированный ответ; total_tokens — сумма. Именно эти числа вы видите в метриках расхода, о которых поговорим в уроке про стоимость.
Когда модель возвращает finish_reason = tool_calls, harness выполняет инструмент локально (на вашем компьютере) и добавляет результат в историю как новое сообщение. Затем формирует следующий запрос — уже с результатом инструмента в контексте. Так продолжается, пока модель не завершит с finish_reason = stop.
Полный цикл одного шага
Соберём всё вместе. Один шаг агента выглядит примерно так.
вы → «Почини баг в модуле auth»
1. запрос к API (история + задача) → модель хочет вызвать read_file
2. harness выполняет read_file, результат в контекст
3. запрос к API (история + результат чтения) → модель хочет вызвать edit_file
4. harness выполняет edit_file, результат в контекст
5. запрос к API (история + итог правки) → finish_reason = stop
6. итоговый ответ вам
В этом примере ваш один вопрос породил три обращения к API. Каждое из них — полная история плюс результат предыдущего действия. Расход токенов растёт с каждым витком, потому что контекст не сбрасывается между запросами: каждый следующий запрос «помнит» всё, что было до него.
Чтобы увидеть настоящую картину расхода, включите recorder и посмотрите лог одного простого шага: «открой файл и исправь опечатку». Вы удивитесь, сколько там запросов с полной историей. После этого оценка «сколько стоил этот шаг» перестанет быть гаданием.
Важный нюанс: разные harness-ы по-разному собирают историю. Одни отправляют каждый результат инструмента отдельным сообщением, другие склеивают несколько шагов. От этого напрямую зависит количество токенов и стоимость шага. Понимание этой механики — первый шаг к осознанному управлению расходами.
Почему один шаг — это несколько запросов
Главная причина множественных запросов — это чередование думание → действие → новый результат → опять думание. Модель не может предсказать результат чтения файла или выполнения команды, поэтому для каждого следующего шага ей нужен свежий запрос с результатом предыдущего.
Сколько именно запросов будет в шаге — зависит от сложности задачи, качества модели (насколько точно она сразу выбирает нужный инструмент) и настроек harness. Встречаются шаги из 1 запроса (простой вопрос, ответ готов сразу) и шаги из 50-100 запросов (крупная задача с множеством правок и запуском тестов).
Из этого следует важный практический вывод.
Стоимость шага определяется не длиной вашего сообщения, а числом витков и размером истории, которую агент передаёт в каждом запросе.
Короткий вопрос «сделай мне фичу» в конце длинной сессии может оказаться дороже длинного вопроса в начале сессии.
Роль инструментов в запросах
Инструменты (tools) — это те самые «руки», которые harness даёт модели. Каждый инструмент описывается схемой: имя, параметры, ожидаемый результат. Схемы инструментов попадают в каждый запрос к провайдеру и, что важно, тоже занимают токены.
{
  "type": "function",
  "function": {
    "name": "bash",
    "description": "Выполнить команду в терминале",
    "parameters": {
      "type": "object",
      "properties": {
        "command": {"type": "string", "description": "Команда для выполнения"}
      },
      "required": ["command"]
    }
  }
}
Если у агента доступно 30 инструментов с подробными описаниями, каждое обращение к API несёт с собой этот «груз» в тысячи токенов. Именно поэтому в больших harness-ах описания инструментов стараются делать краткими, а часть инструментов — скрывать до момента, когда они реально нужны.
Проверьте, сколько токенов уходят на описания инструментов в вашем harness: откройте лог recorder и найдите в первом запросе вхождения blocks «tools»/«system». Если описания съедают заметную долю контекста (10-20%), подумайте, все ли инструменты нужны в каждом запросе — настройка «показывать инструменты по требованию» может заметно удешевить шаги.
Важно и другое: результат работы инструмента тоже попадает в историю и занимает место. Вывод команды на 500 строк, добавленный в контекст, будет отправляться в каждом последующем запросе этого шага. Чем больше «мусора» в выводах инструментов, тем дороже каждый следующий виток — тема, к которой курс вернётся в уроках про устранение избыточности.
Как читать лог запросов
Умение читать лог запросов — базовый навык инженерной работы с агентом. Разберём типичный фрагмент на примере простой задачи — «переименуй функцию в файле».
Запрос 1 (prompt_tokens 5400, completion 120, finish tool_calls)
  → read_file (src/utils.ts)
Запрос 2 (prompt_tokens 5600, completion 90, finish tool_calls)
  → edit_file (src/utils.ts)
Запрос 3 (prompt_tokens 5800, completion 60, finish stop)
  → итоговый ответ
Что видно из этого лога.
- Каждый запрос тяжелее предыдущего: история растёт на результат прочитанного файла и на итог правки.
- finish_reason каждого запроса объясняет переход: первый захотел инструмент, второй — тоже, третий завершился ответом.
- Общий расход шага — сумма всех трёх запросов, а не одного «главного» обращения.
С такими логами связано три типичных заблуждения.
- «Первый запрос — самый дорогой» — нет, самый дорогой обычно последний: в нём вся накопленная история.
- «Короткий вопрос стоит мало» — стоимость определяется историей, а не длиной вопроса.
- «Один шаг = один запрос» — как мы выяснили, это справедливо только для простейших случаев.
Привычка периодически смотреть в лог запросов даёт объективную картину: вы видите, что именно агент делает, сколько шагов ему нужно и где «накручивается» расход. Это знание напрямую пригодится в уроках про стоимость, контекст и управление сессией.
Типичные ошибки
- Путать шаг и запрос: шаг — это весь цикл, а запросов в нём может быть много.
- Оценивать стоимость шага по длине своего сообщения — в расчёт идёт вся история и все витки.
- Игнорировать finish_reason: без него непонятно, почему агент «внезапно» начал читать файлы.
- Считать, что модель всё делает сама — на самом деле между запросами harness выполняет инструменты.
- Не смотреть в usage — без счётчика токенов невозможно осознанно управлять расходами.
Самая системная ошибка — не читать логи запросов вовсе. Пока вы не видели ни одного реального запроса вашего агента, вы управляете расходами и качеством вслепую. Один взгляд в recorder-лог по конкретному шагу даёт больше понимания, чем десятки статей о том, как работают LLM.
Итоги
Каждый запрос несёт всю историю контекста, описание инструментов и параметры выборки; ответ модели сообщает, продолжать ли цикл (finish_reason = tool_calls) или завершить (stop). Расход токенов определяется числом витков и размером истории, поэтому один короткий вопрос в длинной сессии может быть дороже большого запроса в её начале.
В следующем уроке перейдём к понятию сессии и контекстного окна: как история накапливается между шагами, какие у неё пределы и как harness решает, что оставить в контексте, а что отбросить.
Глоссарий
- Шаг (turn) — полный цикл «сообщение пользователя → работа агента → итоговый ответ».
- API-запрос — HTTP-обращение к провайдеру модели с историей, параметрами и списком инструментов.
- Виток (step) — один цикл «запрос к модели → выполнение инструмента → возврат результата» внутри шага.
- Messages — массив сообщений в запросе: вся история, которую модель видит на входе.
- Tool calls — вызовы инструментов, которые модель запрашивает в ответе вместо обычного текста.
- Finish_reason — поле ответа, сообщающее причину завершения генерации (tool_calls или stop).
- Prompt tokens — токены, отправленные на вход модели (история, инструкции, описание инструментов).
- Completion tokens — токены, сгенерированные моделью в ответе.
- Usage — блок ответа со счётчиками потраченных токенов.
- Токен — минимальная единица текста, которой модель считает вход и выход.
- Инструмент (tool) — функция, которую harness даёт модели: чтение файла, запуск команды, поиск.
- Context window — максимальный объём токенов, который модель обрабатывает за один запрос.
- Temperature — параметр выборки, управляющий разбросом ответов.
- Recorder — инструмент записи запросов между агентом и моделью для отладки и анализа расхода.