
- Главная
- Искусственный интелект
- Smart Zone / Dumb Zone: граница ума
Smart Zone / Dumb Zone: граница ума
В предыдущем уроке мы разобрали, что такое сессия и контекстное окно, и что контекст растёт с каждым шагом. Но у этого роста есть скрытое последствие: чем больше контекст, тем хуже модель рассуждает. Это не баг и не случайность — это фундаментальное свойство трансформеров. В этом уроке разберём ключевую концепцию курса: Smart Zone и Dumb Zone, и почему оставаться в Smart Zone — главный навык работы с ИИ-агентом.
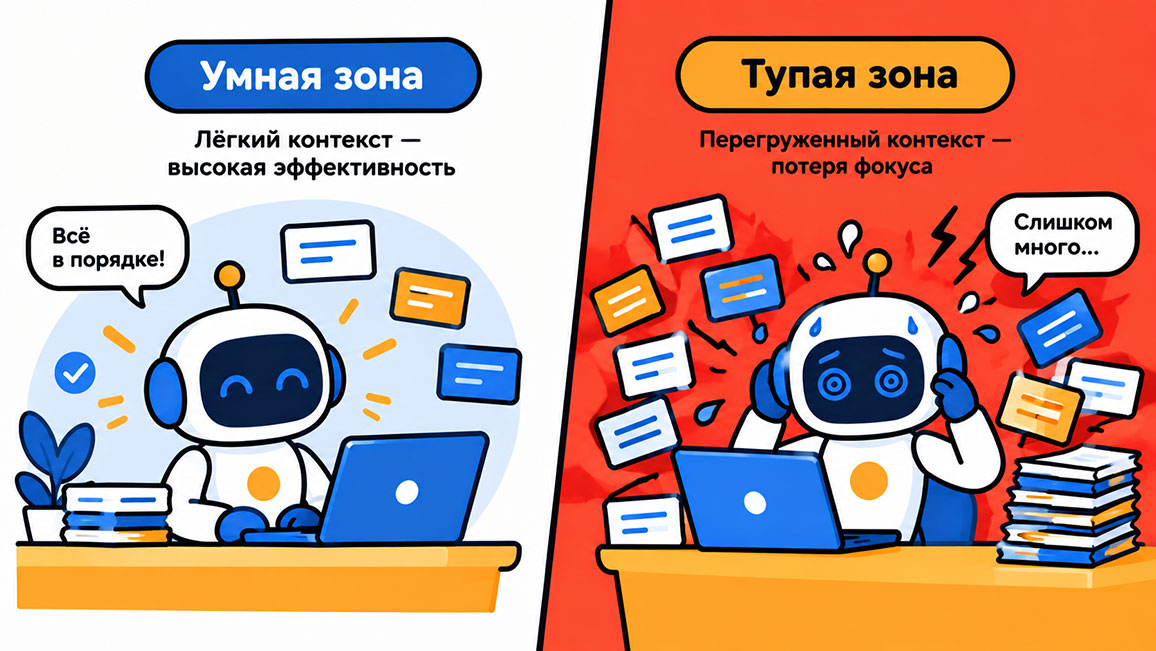
Проблема: контекст растёт — качество падает
Представьте, что вы решаете математическую задачу, а рядом с вами постоянно лежит кипа из 500 страниц малозначимых документов. Чем больше вы в них уткнётесь, тем выше шанс пропустить ключевое условие. С моделью происходит то же самое — только у неё нет способа «отвлечься» от лишнего контекста, кроме как упереться в потолок окна.
Исследования и практика показывают: качество рассуждений модели начинает заметно деградировать задолго до того, как окно заполнено целиком. Уже при заполнении на 40-50% модель может терять точность, а на 70-80% ошибки становятся регулярными. Граница между продуктивной и непродуктивной зоной и есть то, что мы называем Smart Zone и Dumb Zone.
Что такое Smart Zone
В Smart Zone модель работает эффективно:
- Ответы точны и релевантны задаче — модель не «отвлекается» на шум в контексте.
- Стоимость запросов низкая — каждый шаг стоит меньше, потому что контекст маленький.
- Агент не совершает глупых ошибок — не забывает инструкции, не игнорирует ключевые требования.
- Галлюцинации редки — модель опирается на доступный контекст, а не «додумывает» из воздуха.
- Скорость работы высокая — меньше токенов意味着 быстрее генерация.
Граница Smart Zone зависит от модели. У более современных моделей она шире — они дольше сохраняют качество при росте контекста. У старых моделей Smart Zone может заканчиваться уже на 20-30% от окна. Ваша задача — знать свой инструмент и чувствовать, когда начинается деградация.
Проведите простой тест: дайте агенту одну и ту же задачу дважды — в начале сессии (с пустым контекстом) и когда контекст заполнен на 60-70%. Если качество ответа заметно хуже во втором случае — вы зашли за границу Smart Zone. Повторяйте этот тест раз в несколько недель, чтобы натренировать чувство границы.
Что такое Dumb Zone
Характерные признаки Dumb Zone:
- Круговые рассуждения — модель ходит по кругу, повторяя одни и те же мысли разными словами.
- Потеря фокуса — агент «забывает» первые инструкции и начинает делать не то, что просили.
- Шаблонные ответы — вместо глубокого анализа модель выдаёт общие фразы («хороший подход», «нужно учесть»).
- Игнорирование файлов — агент не обращается к прочитанным ранее файлам, хотя те лежат в контексте.
- Упрямство — модель с трудом меняет мнение, даже если вы указываете на ошибку.
Важно понимать: Dumb Zone не наступает внезапно. Это плавный переход: сначала вы замечаете лёгкую «рассеянность» агента, потом — мелкие ошибки, потом — систематические провалы. Граница индивидуальна для каждой модели, но общий принцип един: чем полнее окно, тем тупее агент.
| Характеристика | Smart Zone | Dumb Zone |
|---|---|---|
| Глубина рассуждений | Глубокая, аналитическая | Поверхностная, шаблонная |
| Точность следования инструкциям | Высокая | Низкая (забывает первые указания) |
| Стоимость запросов | Низкая | Высокая (больше токенов) |
| Галлюцинации | Редкие | Частые |
| Гибкость (смена подхода) | Легко меняет мнение | Упрям, плохо корректируется |
| Рекомендуемый уровень заполнения | 0-40% | 60%+ |
Почему это происходит: механика трансформера
Причина лежит в архитектуре трансформера — той технологии, на которой построены все современные LLM. Упрощённо, механизм внимания (attention) модели должен распределить «внимание» между всеми токенами в контексте. Каждый токен «смотрит» на каждый другой токен и решает, насколько он важен. Важных токенов в контексте обычно немного — те несколько тысяч, что содержат суть задачи. Остальное — шум.
Проблема в том, что модель не знает заранее, что важно, а что нет.
Она должна вычислить важность для всех пар токенов, и чем больше токенов, тем больше вычислений. На практике это означает два эффекта:
- Размывание внимания — когда в контексте 100 000 токенов, а релевантных из них 2 000, модель тратит значительную часть вычислительной мощности на оценку неважных токенов. Внимание «размазывается» по всей длине, и ключевые детали получают меньше «веса», чем могли бы.
- Потеря позиционной информации — дальние токены (например, ваши первые инструкции) «затухают» по мере того, как контекст растёт. Модель физически слабее их «видит» на фоне тысяч новых токеров.
Именно поэтому просто «добавить ещё контекста» — не решение. Каждый новый токен не увеличивает полезное знание модели, а лишь усиливает шум, в котором тонут действительно важные детали.
Как определить свою Smart Zone
Эмпирический метод
Возьмите задачу средней сложности — например, написание функции с определёнными требованиями. Выполните её несколько раз в одном и том же проекте, каждый раз — начиная новую сессию, но по-разному искусственно «утяжеляя» контекст перед тем, как дать задачу:
- Первый запуск — чистый контекст, только системный промпт (0% заполнения).
- Второй запуск — добавьте 5 000 токенов «шума» (например, лог файл).
- Третий запуск — добавьте 15 000 токенов шума.
- Четвёртый запуск — добавьте 30 000 токенов шума.
Сравните качество ответов. Тот объём, на котором качество начинает заметно падать — это и есть граница вашей Smart Zone для данной модели. Запомните его в токенах или процентах от окна и используйте как ориентир.
Симптоматический метод
Если вы не хотите проводить тесты, ориентируйтесь по симптомам. Как только замечаете хотя бы два признака из списка Dumb Zone — значит, вы уже на границе или за ней. Время либо завершать задачу, либо переходить в новую сессию.
Многие harness-ы показывают текущее заполнение контекстного окна в статусной строке — в процентах, токенах или визуальной шкале. Если ваш harness это поддерживает, держите эту информацию всегда на виду. Как только заполнение переваливает за 40% — начинайте планировать: либо завершайте текущую задачу, либо готовьте Handoff для новой сессии.
Как оставаться в Smart Zone
Вот базовые приёмы, которые помогают не вылетать из Smart Zone:
- Начинайте новую сессию для каждой крупной задачи. Не пытайтесь сделать всё в одном диалоге. Как только одна задача завершена — сохраните итоги и откройте новую сессию со сжатой выжимкой.
- Не тащите лишнее в контекст. Если файл или вывод не нужен для текущего шага — не давайте агенту его читать. Держите контекст минимально достаточным.
- Используйте Subagents для исследовательских задач. Если нужно изучить код, найти баг или собрать информацию — делайте это в отдельной сессии, а результат передавайте в основную короткой справкой.
- Удаляйте неактуальные сообщения. Некоторые harness-ы позволяют вручную удалять старые сообщения из истории. Если какая-то часть диалога больше не релевантна — удаляйте её, освобождая место.
- Сжимайте историю (Compaction). Когда контекст подходит к границе, используйте авто- или ручное сжатие. Compaction будет разобран в одном из следующих уроков, но уже сейчас знайте: это один из трёх способов остаться в Smart Zone.
Ключевой принцип — проактивность. Не ждите, пока контекст заполнится на 80%. Начинайте действовать на 30-40%. Вовремя завершённая сессия, удалённый неактуальный файл — это работа на опережение, которая сохраняет и качество, и деньги.
Типичные ошибки
- Считать, что модель «всё помнит», если контекст ещё не упёрся в лимит — модель помнит, но качество помнящего уже упало.
- Думать, что Dumb Zone наступает только при 100% заполнении — на деле деградация начинается гораздо раньше.
- Игнорировать симптомы Dumb Zone: «а, он просто не понял, сейчас объясню ещё раз» — нет, он в Dumb Zone, и повторные объяснения не помогут.
- Оценивать качество работы агента по первой задаче сессии и экстраполировать на весь дальнейший диалог — первая задача решается в Smart Zone, а последняя — уже в Dumb Zone.
- Не следить за заполнением контекста — без метрики невозможно осознанно управлять границей.
Итоги
Граница между ними не жёсткая и зависит от модели, но общий принцип един: чем полнее контекст, тем хуже рассуждения. Осознанное управление контекстом — умение вовремя завершать сессии, держать контекст минимально достаточным и не игнорировать симптомы Dumb Zone — это главный навык эффективной работы с ИИ-агентом.
В следующем уроке разберём ещё одно фундаментальное свойство LLM — отсутствие состояния (Statelessness): почему модель не помнит вас между сессиями и как это влияет на архитектуру вашего взаимодействия с агентом.
Глоссарий
- Smart Zone — диапазон заполнения контекстного окна, в котором модель сохраняет высокое качество рассуждений и точность.
- Dumb Zone — диапазон, в котором качество рассуждений модели деградирует из-за переполнения контекста.
- Механизм внимания (Attention) — ключевой компонент архитектуры трансформера, определяющий, на какие токены модель «смотрит» при генерации ответа.
- Размывание внимания — эффект, при котором модель тратит вычислительную мощность на оценку нерелевантных токенов в большом контексте.
- Compaction — сжатие истории сессии для освобождения места в контекстном окне.
- Handoff — передача сжатого состояния задачи из одной сессии в другую.
- Subagent — дочерний агент с собственным контекстом для изолированных исследовательских задач.
- Токен — минимальная единица текста в LLM; «буква» в словаре модели.
- Context window — максимальный объём токенов, который модель может обработать за один запрос.
- Трансформер (Transformer) — архитектура нейронной сети, лежащая в основе всех современных LLM.