
- Главная
- Искусственный интелект
- Почему LLM не помнит ничего между запросами
Почему LLM не помнит ничего между запросами
Ранее мы выяснили, почему с ростом контекста падает качество рассуждений и как оставаться в Smart Zone. Но остаётся главный вопрос: почему вообще приходится таскать весь контекст в каждом запросе? Ответ кроется в фундаментальном свойстве LLM — отсутствии состояния (statelessness). В этом уроке разберём, что это значит, кто на самом деле «помнит» ваш диалог и почему без понимания statelessness невозможно осознанно управлять контекстом.
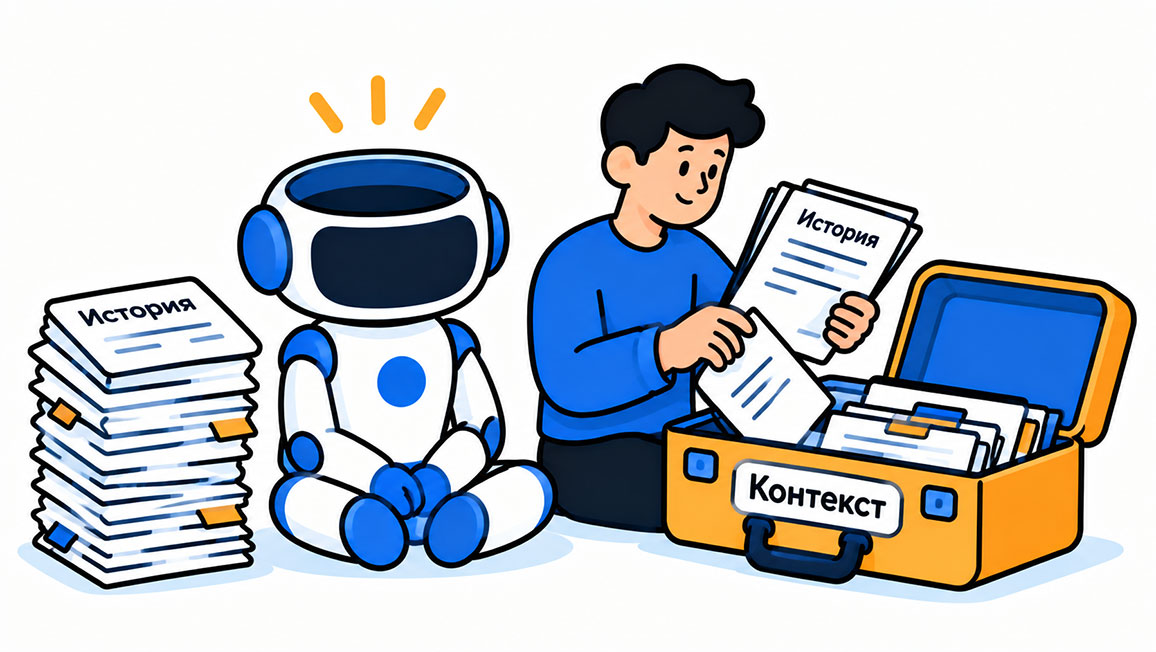
Главное заблуждение об LLM
LLM — это функция без внутренней памяти. Она принимает на вход текст, вычисляет наиболее вероятный следующий токен и возвращает результат. Всё. Между двумя запросами в модели не существует никакого хранилища вашего диалога: ни «блокнота», ни «буфера», ни «воспоминаний». Если отправить модели два одинаковых запроса с одинаковым входом, она не «вспомнит», что уже отвечала на этот вопрос — оба ответа будут вычислены независимо, с нуля.
Полезная метафора — калькулятор. Вы нажимаете 2 + 2 и получаете 4. Потом нажимаете 2 + 2 снова — и калькулятор не говорит я же вам уже отвечал, он снова честно вычисляет 4. Калькулятор не помнит, что вы делали минуту назад. LLM работает точно так же, просто с текстом вместо чисел.
Что такое statelessness
Формально работу модели можно описать как функцию:
ответ = модель(входной_текст)Где входной_текст — это всё, что попало в контекст на момент запроса, а ответ — сгенерированный текст. Никакого скрытого состояния между вызовами нет: модель не «помнит» прошлый входной_текст, не ведёт журнал, не знает, сколько раз вы её вызывали. Единственное, что существует между запросами, — это веса модели: те параметры, которые были зафиксированы при обучении. Но веса — это знания, а не память о вашей сессии.
Отсюда следует ключевой вывод: если в входной_текст не попала какая-то информация, модель о ней не знает — сколько бы раз вы ни говорили об этом раньше. Текст, которого нет в текущем запросе, для модели не существует.
Кто создаёт иллюзию памяти
Если модель ничего не помнит, то почему диалог с ии-агентом выглядит связным? Ответ: память имитирует harness. Это он накапливает историю сообщений и подставляет её в каждый следующий запрос — за счёт этого у вас и возникает ощущение, что модель вас помнит.
Посмотрим, как растёт запрос от шага к шагу:
Шаг 1: [системный промпт] + [ваше сообщение 1] → ответ 1
Шаг 2: [системный промпт] + [сообщение 1] + [ответ 1] + [сообщение 2] → ответ 2
Шаг 3: [системный промпт] + [вся история] + [сообщение 3] → ответ 3
Модель в каждом шаге видит только текущий входной_текст. «Память» о шаге 1 существует не внутри модели, а в запросе шага 3 — как часть пересланной истории. Harness ведёт себя как stateful-система (система с состоянием), хотя сама модель — stateless.
Именно эту связку «stateless-модель + stateful-harness» мы и называем «ИИ-агентом».
| Stateful-система | Stateless-модель |
|---|---|
| Хранит данные между запросами в своей памяти | Не хранит ничего между запросами |
| Помнит прошлые операции автоматически | «Помнит» только то, что передано во входном тексте |
| Пример: база данных, веб-сессия | Пример: LLM, функция, калькулятор |
| В нашей связке — это роль harness | В нашей связке — это роль модели |
Почему это критично для управления контекстом
Вспомните уроки 12 и 13: контекст растёт с каждым шагом, дорожает и «тупеет» по мере заполнения. Почему так? Именно потому, что память агента физически находится в контексте, а контекст пересылается в каждом запросе заново.
- Память = контекст. Всё, что агент «помнит», лежит в запросе. Нет информации в контексте — нет информации у агента, даже если она была в начале диалога.
- Стоимость = пересылка памяти. Чем больше «воспоминаний», тем больше токенов в каждом запросе и тем дороже каждый шаг (урок 15 будет целиком о деньгах).
- Качество = размер памяти. Переполненный контекст отправляет модель в Dumb Zone — слишком много «воспоминаний» ломает рассуждения (урок 13).
- Новая сессия = потеря памяти. Когда вы закрываете сессию, история исчезает, и модель забывает всё — не потому что «перезагрузилась», а потому что контекст больше не пересылается.
Из этого следует главный практический принцип: память агента нужно проектировать самим. Нельзя «положиться на то, что модель запомнит» — она не запомнит ничего. Всю память — итоги, решения, требования, договорённости — надо сознательно класть в контекст: в выжимки, в файлы, в инструкции.
Память бывает разной длительности
Раз statelessness стирает всё между запросами, любой «долговременной памятью» приходится управлять вручную через контекст:
- Краткосрочная — история текущей сессии: живая, пока открыт диалог, исчезает при его закрытии.
- Среднесрочная — выжимки и передача контекста следующей сессии: сжатый итог, который вы передаёте ей текстом.
- Долгосрочная — файлы проекта вроде
AGENTS.mdи автоматическая память (auto-memory): то, что агент читает при старте каждой новой сессии.
Все три уровня — это по-прежнему просто текст, попадающий в контекст. Разница лишь в том, кто и когда его туда кладёт: harness — автоматически, вы — вручную, файлы — при старте сессии.
Практические следствия statelessness
Понимание statelessness меняет то, как вы работаете с агентом. Вот стратегии, которые работают именно потому, что модель не помнит ничего сама:
- Записывайте решения в файлы. Не держите важное «в голове диалога» — попросите агента фиксировать итоги в файле проекта. Новая сессия прочитает файл и «вспомнит» всё.
- Создавайте выжимку перед сменой сессии. Как мы обсуждали в уроке 12: краткий итог «что сделано, что решено, что осталось» заменяет всю историю в следующем контексте.
- Держите инструкции в
AGENTS.md. Правила и требования должны жить в файле, который загружается при старте, а не в сообщениях, которые тонут в истории. - Повторяйте ключевое в нужный момент. Модель «помнит» только то, что видит сейчас. Не стесняйтесь напомнить важное условие прямо перед тем, как оно понадобится.
- Используйте память как инструмент, а не как данность. Раз вы управляете контекстом — вы управляете памятью. Это и есть суть профессии «инженер ИИ-агентов».
Заведите в проекте файл-«память», например NOTES.md, и в конце каждой сессии просите агента дописать туда итоги одним абзацем. Перед началом новой сессии дайте агенту прочитать этот файл. Так вы получите дешёвую долговременную память, не переплачивая за пересылку всей истории — особенно полезно для тем, которые тянутся неделями.
Что statelessness НЕ значит
У этой концепции есть частые неверные трактовки, которые стоит сразу отсечь.
- Это не значит, что LLM бесполезны в диалоге. Связность обеспечивает harness — и этого достаточно для большинства задач, пока вы управляете контекстом.
- Это не значит, что у модели «нет знаний». Веса модели хранят знания, полученные при обучении: языки, код, факты. Но это память «человечества», а не память о вашей сессии.
- Это не особенность конкретного провайдера. Statelessness присуща всем LLM — от маленьких локальных до самых больших облачных. Меняются только размеры окна и цена, но принцип «запрос обрабатывается с нуля» — неизменен.
- Это не значит, что «контекст можно не передавать». Наоборот: раз памяти нет, передача контекста — единственный способ дать модели знания о вашей задаче.
Типичные ошибки
- Считать, что модель «помнит» первую инструкцию из начала длинного диалога — она помнит только то, что физически осталось в контексте, а внимание к дальним токенам затухает.
- Полагаться на память при переходе в новую сессию без передачи выжимки — модель стартует с пустым контекстом и не знает о вашем проекте ничего.
- Пытаться «напомнить» модели что-то словами, не добавив это в контекст — например, говорить «ну ты же помнишь, мы обсуждали…» вместо того, чтобы повторить условие.
- Хранить важные договорённости только в чате, а не в файлах — после закрытия сессии они исчезают безвозвратно.
- Покупать «модель с памятью» в надежде решить проблему контекста — память в любом случае эмулируется через контекст, и управлять ею придётся вам.
Если важный факт «выпал» из поведения агента в конце длинной сессии, не спорьте с ним и не повторяйте условие пять раз — начните новую сессию, положите в неё выжимку и ключевые требования прямо в первом сообщении. Так вы вернётесь в Smart Zone и дадите модели «память» в самом заметном месте контекста.
Итоги
Иллюзию памяти создаёт harness, который пересылает историю в контексте каждого запроса, и именно поэтому контекст растёт, дорожает и влияет на качество рассуждений. Управлять контекстом — значит управлять памятью агента: класть в неё только нужное, вовремя сжимать и передавать выжимки в новые сессии. Это не ограничение, а ваш главный рычаг управления.
В следующем уроке перейдём к деньгам: разберём, как отслеживать и оценивать стоимость API-вызовов — сколько на самом деле тратится на каждый шаг агента и как контролировать бюджет.
Глоссарий
- Statelessness (отсутствие состояния) — свойство обрабатывать каждый запрос автономно, не сохраняя данные между запросами.
- Stateful-система — система, которая хранит состояние между операциями (база данных, веб-сессия, harness).
- LLM — большая языковая модель; функция, вычисляющая следующий токен по входному тексту.
- Harness — программа, связывающая пользователя и модель: ведёт историю и подставляет её в запросы, создавая иллюзию памяти.
- Контекст (context) — весь текст, переданный модели в конкретном запросе.
- История сообщений — накопленная переписка и результаты инструментов, которые harness пересылает в каждом запросе.
- Токен — минимальная единица текста, которой модель считает вход и выход.
- Веса модели — параметры, зафиксированные при обучении; хранят знания, но не память о сессии.
- Выжимка — краткий итог сессии («что сделано, что решено, что осталось»), передаваемый следующей сессии.
- Handoff — структурированная передача состояния задачи из одной сессии в другую.
- AGENTS.md — файл инструкций проекта, который агент загружает при старте сессии как «долговременную память».
- Session (сессия) — период непрерывной работы агента, в течение которого harness накапливает историю.