
- Главная
- Искусственный интелект
- Выбор плана и модели для ИИ-агента
Выбор плана и модели для ИИ-агента
Модель, которую вы подключаете к ИИ-агенту, определяет качество результата, скорость работы и размер счёта в конце месяца. В этом уроке разберём, из чего складываются планы и тарифы, чем отличаются классы моделей и как выбрать конфигурацию под конкретную задачу.
Главная идея: выбор модели — это не вкусовщина, а инженерное решение с измеримыми параметрами.
Почему выбор модели — инженерное решение
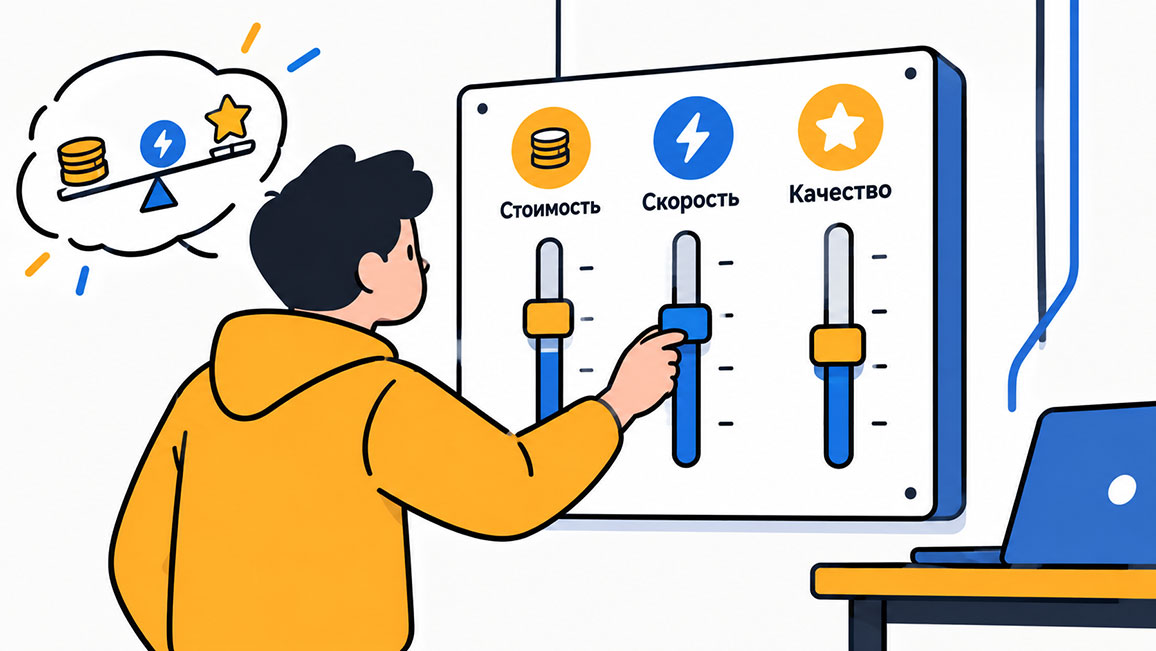
Новичок обычно спрашивает «какая модель лучше» и ждёт один ответ навсегда. На практике ответ всегда один: «зависит от задачи». У любой модели есть три ограниченных ресурса, и выбор сводится к балансу между ними:
- Деньги — стоимость входных и выходных токенов или цена подписки.
- Время — скорость генерации ответа и время ожидания пользователя.
- Качество — способность рассуждать, удерживать контекст и выдавать корректный код.
Улучшение одного параметра почти всегда ухудшает другой.
Самая «умная» модель отвечает медленно и стоит дорого, самая дешёвая — быстро, но на сложной задаче может ошибиться. Задача инженера — найти точку баланса, а не гнаться за максимумом по одному критерию.
Три параметра выбора
Качество рассуждений
Это способность модели решать многошаговые задачи: планировать, анализировать ошибки, переписывать архитектуру. На простых задачах разница между моделями невелика, но на сложных она становится решающей.
Скорость
Быстрый ответ важен в интерактивной работе: пока агент «думает», вы ждёте. Для мелких правок задержка в несколько секунд терпима, для долгих сеансов рефакторинга — уже нет.
Стоимость
Складывается из цены за входные и выходные токены. Дорогая модель при активной работе может стоить в десятки раз больше дешёвой, поэтому важно считать не цену за запрос, а цену за результат.
Классы моделей
Модели с длинным рассуждением
Такие модели перед ответом «думают»: строят внутренние рассуждения, проверяют гипотезы, перепроверяют себя. Их стихия — сложные задачи: проектирование, отладка, миграции, ревью. Минусы — медленнее и дороже.
Быстрые универсальные модели
Отвечают почти мгновенно и хорошо справляются с типовыми задачами: объяснить код, написать тест, поправить баг. Оптимальны для повседневной работы, когда задержка важнее глубины рассуждений.
Компактные модели
Малые модели с минимальной ценой. Подходят для однозначных задач: переписать функцию, отформатировать код, извлечь данные. На сложных задачах требуют контроля и частых проверок результата.
| Класс модели | Когда выбирать |
|---|---|
| С длинным рассуждением | Архитектура, отладка, ревью, миграции |
| Быстрая универсальная | Повседневная разработка, типовые правки |
| Компактная | Однозначные задачи, массовая обработка |
Из чего складывается тариф
Поставщики обычно предлагают два способа оплаты, и важно понимать разницу заранее.
Подписка с фиксированной ценой
Вы платите фиксированную сумму в месяц и получаете лимит запросов. Подходит, если работаете с агентом ежедневно. Смотрите не только цену, но и лимиты: сколько запросов в час и в день, какой максимум context window, есть ли приоритетный доступ в часы пик.
Оплата за использование
Цена за токены — прозрачная схема для редкой работы, но расход легко недооценить. Базовая формула простая:
Стоимость = (входные токены × цена входа) + (выходные токены × цена выхода)Пример прикидки бюджета на один сеанс работы с агентом:
Вход:  150 000 токенов × $2 за 1 млн = $0,30
Выход:  30 000 токенов × $8 за 1 млн = $0,24
Итого за сеанс: ≈ $0,54
Обратите внимание: входные токены обычно дешевле выходных, но их в разы больше — агент постоянно пересылает историю диалога. Подробнее о расходе контекста — в уроках про сессии и контекст.
Начинайте с быстрой дешёвой модели, а «умную» подключайте только когда упрётесь в качество. Большинство задач не требуют максимального reasoning — так вы сэкономите и деньги, и время ожидания.
Лимиты и rate limits
Даже по подписке есть ограничения: максимум запросов в минуту, максимум токенов на запрос, максимум сообщений в сеанс. Превышение лимита приводит к паузам или ошибкам, поэтому при выборе плана сравнивайте не только цену, но и лимиты.
Как прикинуть стоимость проекта
Лучший способ — не гадать, а снять замеры на небольшой выборке. Возьмите три-пять типовых задач и прогоните их на кандидатах. Считайте не цену одного запроса, а полную стоимость сеанса: вход плюс выход плюс повторные попытки после ошибок.
- Зафиксируйте среднее число токенов на типовую задачу.
- Умножьте на число задач в день.
- Сравните итог с ценой подписки.
- Добавьте запас на неудачные попытки и повторы.
Если суммарный расход приближается к цене подписки или превышает её — подписка выгоднее. Если работаете редко — оплата за использование дешевле.
Матрица выбора под задачу
Сведите решение к простому правилу: сложность задачи определяет класс модели.
| Задача | Рекомендуемый класс |
|---|---|
| Новая фича с нуля | С длинным рассуждением |
| Починка бага | Быстрая универсальная |
| Форматирование кода | Компактная |
| Миграция базы данных | С длинным рассуждением |
| Объяснение фрагмента кода | Быстрая универсальная |
| Массовая генерация шаблонов | Компактная |
Стратегия нескольких моделей
Многие harness поддерживают переключение модели внутри сессии и запуск субагентов на других моделях. Подробнее — в уроке про субагентов, а пока запомните базовую схему:
- Планирование и проектирование — сильная модель.
- Реализация и мелкие правки — быстрая модель.
- Массовые однотипные операции — компактная модель.
- Финальная проверка и ревью — сильная модель.
Типичные ошибки
- Выбор «самой умной» модели для всех задач — переплата и медленная работа.
- Экономия на всём подряд — низкое качество на ключевых этапах.
- Оценка бюджета по цене одного запроса, а не сеанса.
- Игнорирование лимитов тарифа — неожиданные паузы в работе.
- Смена моделей без замеров — невозможно понять, что улучшилось.
Ведите «журнал замеров»: один файл, куда записываете задачу, модель, время выполнения, стоимость и оценку результата. Через неделю у вас будет персональная таблица, по которой видно, какая модель реально выгодна под ваши задачи.
Итоги
Выбор плана и модели — это баланс между стоимостью, скоростью и качеством рассуждений под конкретный тип задач. Начинайте с быстрой модели, подключайте сильную по необходимости, а решения принимайте на основе замеров, а не рекламы.
В следующем уроке настроим учебный проект: инициализируем репозиторий, установим зависимости и запустим первое упражнение.
Глоссарий
- LLM — большая языковая модель, генерирующая ответы на запросы.
- Тариф (план) — условия оплаты и лимиты использования модели.
- Подписка — фиксированная ежемесячная оплата с лимитами.
- Pay-as-you-go — оплата за фактическое использование токенов.
- Токен — единица текста, которой измеряется вход и выход.
- Входные токены — токены запроса и истории диалога.
- Выходные токены — токены ответа модели.
- Reasoning — «рассуждение» модели перед выдачей ответа.
- Context window — объём текста, который модель «помнит» в сессии.
- Rate limit — ограничение числа запросов в единицу времени.
- Harness — оболочка, через которую вы работаете с моделью.
- Субагент — отдельный агент с независимым контекстом.
- Маршрутизация — распределение задач между разными моделями.