
- Главная
- Искусственный интелект
- Зачем нужен курс по ИИ-агентам в разработке
Зачем нужен курс по ИИ-агентам в разработке
Это первый урок курса «ИИ-агенты в разработке: от нуля до продакшена». Из него вы узнаете, зачем вообще нужна отдельная методология при работе с ИИ-агентами, если можно просто писать промпты и смотреть, что получится. А ещё разберётесь, как устроен сам курс и что от вас потребуется, чтобы пройти его с максимальной пользой.
Зачем нужен этот курс
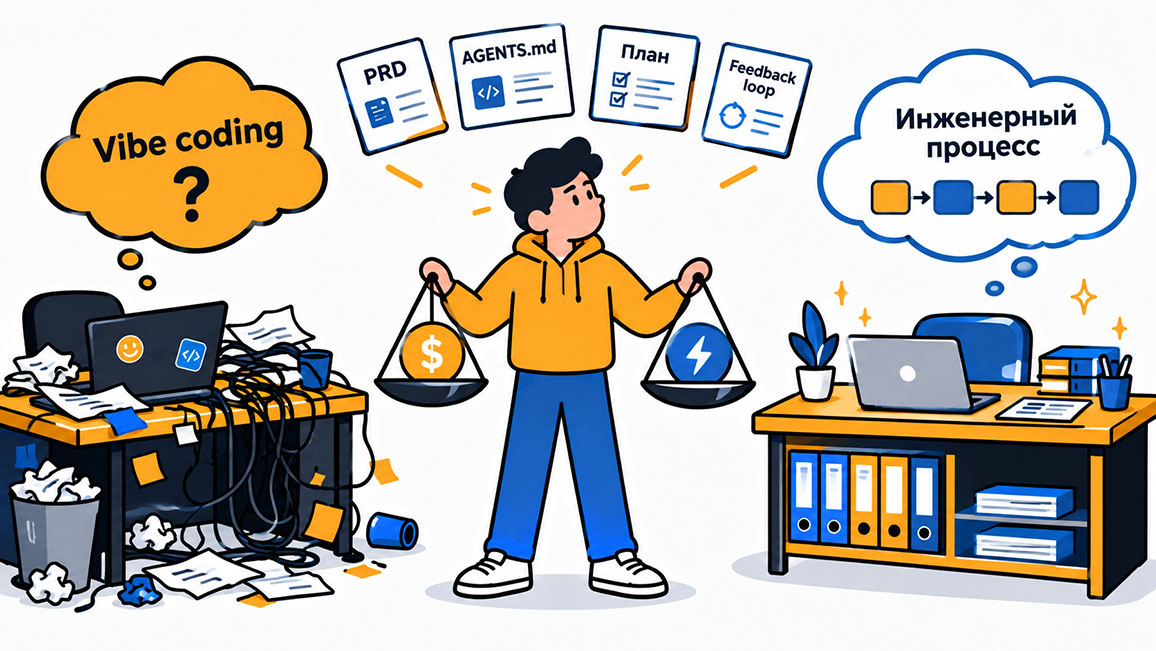
Такой подход называют vibe coding — вы полагаетесь на интуицию и удачу, а не на процесс. Работает это до первого сложного проекта: агент теряет контекст задачи, придумывает несуществующие API, переписывает то, что уже работало, а вы не можете объяснить коллеге, почему результат именно такой.
Этот курс учит другому подходу — превратить работу с агентом в повторяемый инженерный процесс.
Вместо того чтобы каждый раз изобретать промпт заново, вы получите набор конкретных приёмов: как управлять контекстом, как формулировать задачу агенту, как проверять результат и как масштабировать это на большие фичи и целые команды.
Курс рассчитан на разработчиков, у которых уже есть опыт работы с ИИ-агентами в связке с реальной кодовой базой, но результат пока непредсказуем: иногда агент отлично справляется, а иногда портит рабочий код. Если это про вас, дальнейшие уроки будут точно полезны.
Инженерный процесс вместо vibe coding
Разница между двумя подходами хорошо видна, если сравнить их по нескольким критериям.
| Критерий | Как отличаются подходы |
|---|---|
| Предсказуемость результата | При vibe coding зависит от удачного промпта, в инженерном процессе — задаётся структурой задачи и context |
| Использование context | При vibe coding не контролируется и забивается «мусором», в инженерном процессе — осознанно очищается и структурируется |
| Работа в команде | При vibe coding сложно передать другому человеку, в инженерном процессе есть общие артефакты — PRD, AGENTS.md, планы |
| Стоимость ошибок | При vibe coding обнаруживается поздно, в инженерном процессе ловится на ранних этапах через feedback loops |
Именно вторая колонка — то, к чему мы будем идти на протяжении всего курса. Каждый последующий урок добавляет один конкретный кирпичик в этот процесс: понятие, приём или инструмент.
Что вы получите после прохождения курса
В частности, вы научитесь:
- чётко разграничивать понятия LLM, harness, agent и environment;
- распознавать smart zone и dumb zone и удерживать сессию агента в продуктивном состоянии;
- формулировать задачи через цикл Grill-Execute-Clear вместо расплывчатых промптов;
- писать инструкции для агента в файлах вроде
AGENTS.mdи переиспользуемые Skills; - разбивать крупные фичи на фазы, которые помещаются в одну сессию;
- настраивать обратные связи — линтеры, типизацию, тесты — как контроль качества для агента.
Все эти темы не абстрактные — каждая привязана к конкретной проблеме, с которой вы столкнётесь на практике, и к конкретному решению этой проблемы.
Как устроен курс
Курс разбит на смысловые блоки, и каждый следующий опирается на предыдущий.
Первая половина курса
Здесь закладывается терминология и ментальная модель: что такое context, session, turn, почему LLM не хранит состояние между запросами и откуда берутся галлюцинации. Без этого фундамента сложно понять, зачем нужны более сложные приёмы дальше.
Вторая половина курса
Дальше начинается практика: управление сессией агента в терминале и IDE, методология Grill-Execute-Clear, файлы AGENTS.md и Skills, работа с крупными фичами через PRD и многофазные планы, а также TDD и feedback loops как способ держать качество кода под контролем.
Практические упражнения курса выполняются на демо-проекте на React и TypeScript. Уже сейчас возьмите за привычку писать компоненты как небольшие функции с чётко описанными пропсами через type или interface — агенту, как и человеку, гораздо проще читать и безопасно менять маленький предсказуемый компонент, чем большой файл на тысячу строк со смешанной логикой.
Как проходить уроки
Уроки курса текстовые, без видео — так удобнее возвращаться к конкретному фрагменту и копировать команды. Структура почти каждого урока одинаковая: сначала описывается проблема, с которой вы реально столкнётесь при работе с агентом, затем — конкретное решение, которое можно сразу применить.
Там, где это уместно, урок сопровождается упражнением: вы вносите изменения в учебный проект, коммитите результат и сверяете его с эталоном. Такой формат специально выбран, чтобы знания не оставались теорией, а сразу закреплялись в мышечной памяти работы с агентом.
Что нужно для старта
Для комфортного прохождения курса пригодится базовый опыт работы с git и командной строкой, а также установленный Node.js и npm — учебный проект и recorder запросов, которые вы настроите в следующих уроках, работают поверх этого стека. Если что-то из перечисленного ещё не установлено, сделайте это до следующего урока — там мы сразу перейдём к настройке учебного проекта.
Глубокие знания React или TypeScript не обязательны — курс не учит фронтенду, он учит работать с агентом. Но раз демо-проект написан на этом стеке, минимальное знакомство с синтаксисом ускорит понимание примеров.
Если демо-проект (или ваш собственный) уже на TypeScript, включите строгий режим через флаг --strict в tsconfig.json с самого начала, а не «когда-нибудь потом». Агенту строгая типизация даёт мгновенную и точную обратную связь об ошибках, а вам — меньше шансов получить код, который компилируется, но падает в рантайме.
Итоги
В этом уроке мы разобрались, чем инженерный процесс работы с ИИ-агентом отличается от vibe coding, какие результаты даёт прохождение курса и как устроены сами уроки — от текстового формата до практических упражнений с коммитами. Также обозначили минимальный набор инструментов, который понадобится для старта.
В следующем уроке разберёмся, как выбирать план и модель под конкретную задачу, чтобы не переплачивать за скорость и не терять в качестве рассуждений там, где оно критично.
Глоссарий
Ниже — краткие пояснения терминов, которые встретились в этом уроке. Подробно каждый из них разберём в соответствующих уроках дальше по курсу.
- Vibe coding — неструктурированный способ работы с агентом: написал промпт, посмотрел на результат, поправил, повторил. Результат зависит от удачи, а не от процесса.
- Context (контекст) — вся информация, которую агент «видит» в текущий момент: история переписки, код, инструкции и результаты предыдущих шагов.
- LLM — большая языковая модель, которая генерирует текст и код на основе полученного контекста.
- Harness — программная обвязка вокруг модели: она отправляет запросы, получает ответы и даёт агенту доступ к файлам, командам и другим инструментам.
- Agent (агент) — связка модели и harness, способная самостоятельно выполнять многошаговые задачи: писать код, запускать команды, проверять результат.
- Environment (среда) — рабочее окружение агента: файловая система проекта и доступные ему инструменты и команды.
- Smart zone / dumb zone — состояние заполненности контекста. Пока контекст в разумных пределах, агент рассуждает качественно (smart zone), при перегрузке качество резко падает (dumb zone).
- Session (сессия) — один непрерывный «разговор» с агентом от старта до сброса контекста.
- Turn (ход) — один цикл запрос-ответ между вами (или агентом) и моделью в рамках сессии.
- Галлюцинации — ситуации, когда модель уверенно выдаёт неверную или несуществующую информацию, например придуманный API.
- Grill-Execute-Clear — методология курса: агент подробно «допрашивает» вас по задаче (Grill), выполняет работу (Execute), после чего контекст очищается перед новой задачей (Clear).
- AGENTS.md — файл с инструкциями для агента о проекте: правила, соглашения и контекст, которые нужно учитывать при работе с кодовой базой.
- Skills — переиспользуемые пакеты инструкций и промптов, которые агент подключает по мере необходимости для повторяющихся задач.
- PRD (Product Requirements Document) — документ с чётким описанием требований к фиче, чтобы агент понимал точную задачу перед реализацией.
- Feedback loops (обратные связи) — автоматические проверки вроде линтеров, типизации и тестов, которые быстро сообщают агенту об ошибках в его коде.
- TDD — разработка через тестирование: сначала пишется тест, затем код, который заставляет этот тест пройти.
- Recorder запросов — инструмент, который записывает обмен данными между агентом и моделью, чтобы отслеживать расход контекста и искать причины проблем.