
- Главная
- Искусственный интелект
- Выбор модели ИИ-агента: критерии и стратегия
Выбор модели ИИ-агента: критерии и стратегия
На прошлом уроке мы научились управлять усилиями рассуждения, но усилие — лишь половина уравнения: оно решает, насколько близко модель подбирается к своему потолку, а сам потолок задаёт выбор модели. В этом уроке разберём углублённо, чем отличаются модели для разных задач, по каким критериям их выбирать, как читать спецификации и сравнивать модели в паре с усилием, не полагаясь на рекламные цифры.
Почему модель — главный рычаг
Выбрать неподходящую модель — значит упереться в потолок, который не пробить ни контекстом, ни усилиями. Если модель слаба в анализе кода, никакой объём контекста не сделает её сильной; если она плохо следует формату, высокий effort лишь красиво объяснит, почему формат всё равно сломан. Поэтому выбор модели — это не «один из шагов», а фундамент, на котором строятся все остальные приёмы курса.
Хорошая новость: моделей сейчас много, и искать «лучшую вообще» не нужно — нужно научиться подбирать подходящую под конкретный тип работы. Именно этому посвящён урок.
Оси сравнения моделей
- Качество рассуждения — способность решать многошаговые задачи: отладка, планирование, ревью. Это главная ось для агентной работы, и именно её Effort (урок 17) регулирует приближение к потолку. Качество рассуждения нельзя измерить «в лоб», о нём судят по бенчмаркам и собственным прогонам.
- Размер контекста — сколько информации модель может удержать в одном запросе. Чем больше контекст, тем больше файлов и вывода команд можно передать агенту за раз. Но большой контекст — не бесплатный: он дороже, медленнее, а способность «не терять» середину контекста у моделей разная (урок 13 о Smart Zone объясняет, почему заполнять контекст под потолок вредно).
- Скорость вывода — токены в секунду. Интерактивная работа в терминале, частые мелкие правки, длительные автономные циклы — в каждом случае скорость важна по-своему. Быстрая модель, которая «тормозит» вас реже, побеждает медленную «аналогичной» мощности на задачах с множеством коротких запросов.
- Цена за токены — входные и выходные токены, включая токены рассуждения. Из уроков 15 и 17 мы знаем, что считать нужно не цену за запрос, а цену всей задачи, включая повторные попытки и внутренние рассуждения. Дешёвая «по прайсу» модель, которая требует трёх попыток, часто дороже, чем дорогая «по прайсу», которая справляется с первой.
- Следование инструкциям — насколько точно модель выполняет требования формата, порядка шагов, ограничений. Для агентов это критично: сломанный формат JSON, пропущенный шаг, игнорирование правила — это не «мелочи», а реальная стоимость повторных запросов и ручной правки.
- Экосистема и инструменты — совместимость с вашим harness, поддержка skills, качество интеграции с IDE. Все без исключения уроки курса про инструменты, которые удобнее иметь переиспользуемыми: AGENTS.md-инструкции, skills, recorder-логи — всё должно одинаково хорошо работать с той моделью, которую вы выбрали.
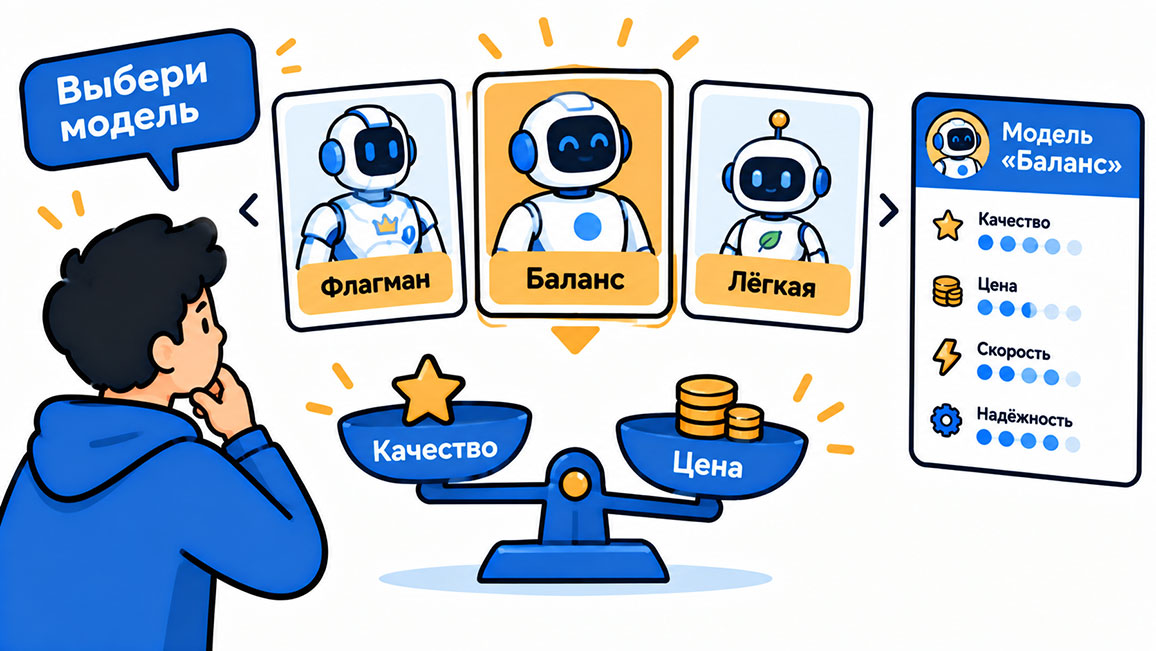
Запомните главное: ни одна модель не выигрывает по всем осям сразу. Обычно это треугольник качество — скорость — цена, и позиция в нём у каждой модели своя.
Семейства моделей и их ниши
- Флагманские модели — самые мощные модели провайдеров, нацеленные на максимум качества рассуждения. Их ниша — сложная отладка, планирование фич, ревью архитектуры, разбор непонятного поведения системы. Минусы: высокая цена, задержки, токены рассуждения. Используются точечно, когда задача действительно сложная, а не для каждой мелочи.
- Балансовые модели — класс «золотой середины»: заметно дешевле и быстрее флагманов при небольшой потере качества на сложных задачах. Это рабочие лошадки агента: рефакторинг, написание функций средней сложности, объяснение кода, генерация запросов. Именно на них держится большая часть ежедневной работы, а высокий effort (урок 17) иногда позволяет догнать флагман за меньшие деньги.
- Лёгкие/быстрые модели — минимальный класс: максимальная скорость и цена при ограниченном рассуждении. Их ниша — перефразирование, извлечение данных, короткие правки, массовые простые операции. Ставить их на отладку — ошибка, но гонять флагман на переименование переменной — не меньшая ошибка.
- Специализированные модели — модели, заточенные под конкретный домен: код, математику, анализ таблиц, мультимодальность. Если ваша задача — почти всегда код, специализированная кодовая модель может дать качество флагмана по цене балансовой. Но узкая специализация означает слабость вне домена: не ожидайте от «математической» модели выдающегося ревью архитектуры.
На практике у большинства провайдеров вы видите линейку из двух-трех представителей этих семейств. Понимание ниши помогает ответить на вопрос «какую взять», даже не глядя в спецификации: сначала определите класс задачи, потом подберите семейство.
Как читать спецификации моделей
Контекстное окно указывает максимум входных токенов. Из уроков 12–14 помним: заполнять окно под потолок нельзя, иначе попадаем в Dumb Zone. Практически полезный контекст — меньше заявленного, поэтому сравнивайте модели не «по циферке», а по тому, сколько реального кода и вывода команд влезает до потери качества рассуждения.
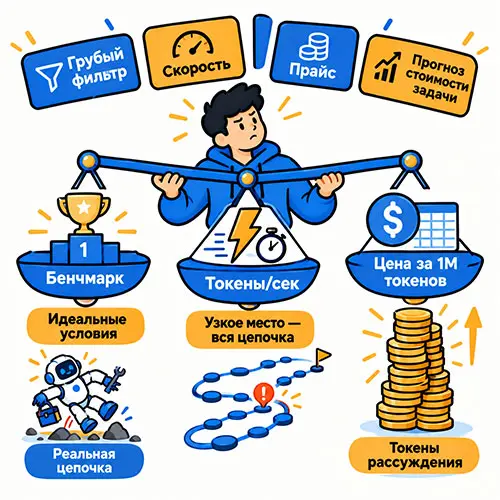
Бенчмарки — оценки на тестах. Их главная ловушка: они измеряют отдельный навык в идеальных условиях, а не поведение в реальной агентной цепочке с инструментами и многошаговым циклом. Используйте бенчмарки как грубый фильтр, а не как решающий аргумент: две модели с разницей в пару процентов на тесте могут в реальной работе вести себя совершенно иначе.
Скорость вывода — токены в секунду под нагрузкой. Цифры у провайдеров различаются в разы, и для интерактивной работы это ощутимо. Однако помните: на длинных автономных циклах агенту всё равно, сколько ждать один запрос — узкое место там вся последовательность действий, а не скорость одного вывода.
Прайс — таблица «цена за миллион входных/выходных токенов». Ключевой пункт — токены рассуждения: у рассуждающих моделей финальный счёт на сложных задачах может быть в разы выше «чистого» ответа. Поэтому сравнивайте не прайс, а прогноз стоимости типовой задачи.
Отдельно про дату релиза. Модели обновляются быстро, и годовалый «флагман» часто уступает свежей балансовой модели. Регулярно пересматривайте линейку, но не гонитесь за каждым релизом: смена рабочей модели — это тоже стоимость (нужно перепроверить skills, формат ответов, поведение агента).
И помните: спецификации описывают модель «на бумаге», а агент живёт в связке модель + harness + инструменты. Финальный судья — прогон на ваших реальных задачах.
Критерии выбора под задачу
- Простая и массовая работа: короткие правки, перефразирование, извлечение данных, массовые операции. Выбирайте лёгкую модель. Выигрыш от флагмана здесь близок к нулю, а лишние токены и задержки — реальны.
- Средняя работа: написание функций, рефакторинг, объяснение кода, генерация запросов. Балансовая модель — точка входа. Если качество не устраивает, сначала поднимите effort, и только потом пробуйте флагман. Из урока 17: пара «балансовая + высокий effort» часто дешевле и без заметной потери качества.
- Сложная работа: отладка, планирование, ревью архитектуры, разбор чужих ошибок. Флагман или специализированная кодовая модель с высоким effort. Здесь экономия на модели почти гарантированно оборачивается лишними циклами и повторными запросами, то есть итоговой переплатой.
- Долгие автономные циклы: задача тянется десятки запросов. Скорость вывода выходит на первый план: медленный флагман растянет цикл в разы. Но следите и за стабильностью: если модель «сходит с ума» в середине длинного цикла, вся экономия скорости теряется на перезапусках.
- Задачи с жёсткими форматами: интеграция с внешними системами, требующая точного JSON или специфичной схемы. Ищите модель с сильным следованием инструкциям. Даже небольшая разница в «послушности» формату оборачивается десятками сэкономленных циклов правок.
Приведём сводную таблицу для быстрой ориентации.
| Тип работы | Семейство | Effort |
|---|---|---|
| Короткие правки, извлечение данных | Лёгкая модель | Низкий |
| Функции, рефакторинг, объяснение | Балансовая модель | Средний |
| Отладка, планирование, ревью | Флагман | Высокий |
| Кодовая специализация | Кодовая модель | Средний/высокий |
| Долгие автономные циклы | Быстрая модель | По задаче |
| Жёсткие форматы | Сильная по инструкциям | Средний |
Модель и усилие в паре
модель + effort. Разберём ключевые комбинации, чтобы не перебирать их вслепую.Комбинация балансовая модель + высокий effort — самая недооценённая. На задачах с понятным контекстом она часто дотягивается до флагмана со средним effort, но заметно дешевле. Работает там, где нужно «подумать», но рассуждение опирается на факты, которые уже в контексте. Перестаёт работать, когда задача упирается в сам потолок качества модели: усилия не создают способности, которой нет.
Комбинация «флагман + низкий effort» — казалось бы, бессмысленная трата. Но она имеет право на жизнь в двух случаях: когда нужен быстрый ответ с максимально высокой базовой культурой рассуждения и когда в задаче критично следование инструкциям, а не глубина. Только считайте деньги: входные токены флагмана всё равно дорогие.
Комбинация «лёгкая модель + высокий effort» — почти всегда провал. Лёгкие модели рассуждают «дёшево»: длинная цепочка внутренних токенов не компенсирует отсутствие способности, и вы платите за видимость усилий. Если лёгкая модель не справилась, не мучайте её effort — меняйте семейство.
Проверяйте связку модель + effort парным прогоном: одну и ту же реальную задачу запустите на балансовой + высокий effort и на флагмане + средний effort, сравните качество и расходы в логах recorder. Таких двух прогонов достаточно, чтобы принять решение для целого класса похожих задач.
Практическое правило: начинайте с балансовой модели и среднего effort. Если не хватает качества — сначала поднимите effort, затем пробуйте флагман. Если не хватает скорости — сначала снизьте effort, затем ищите более быструю модель в том же семействе. Переставляйте рычаги по одному, и лог всегда покажет, какой из них сработал.
Смена модели без разрушения привычек
Первый шаг после смены модели — прогнать свои skills и типовые промпты на небольшом наборе задач. Разные модели по-разному следуют инструкциям: то, что одна выполняет буквально, другая трактует «творчески». Быстрая проверка на пяти типовых задачах ловит большинство расхождений до того, как они подорвут доверие.
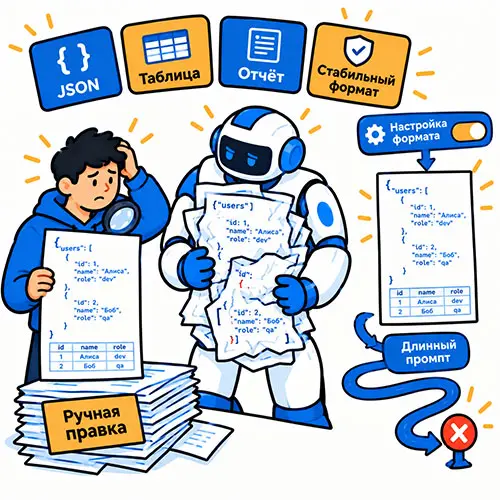
Второй шаг — перепроверить формат выводов, особенно там, где агент отдаёт структурированные данные: JSON, таблицы, файлы-отчёты. Новая модель может быть мощнее, но «непослушнее» в формате, и это обернётся ручной правкой. Если формат сломан, не пишите длинный промпт — проверьте, нет ли у модели настроек для стабильного формата, и только потом усиливайте инструкции.
Третий шаг — обратить внимание на поведение в долгих сессиях. У разных моделей разный «порог усталости» в заполненном контексте (урок 13), разное поведение при толкании к Dumb Zone. Если новая модель деградирует раньше, чем прежняя, ваши привычки по длине сессий придётся скорректировать.
Ведите мини-таблицу «задача × модель»: одна строка на типовую задачу, колонки — цена в токенах из recorder, время, качество. После смены модели таблица отвечает на вопрос «стало ли лучше» цифрами, а не ощущениями. Один файл на проект, и решение о возврате или закреплении новой модели становится объективным.
Типичные ошибки
- Гнаться за «самой мощной» моделью для всех задач — флагман на мелочах переплачивает и замедляет работу, не давая выигрыша в качестве.
- Экономить на модели для сложных задач — слабая модель на отладке тянет за собой повторные циклы, которые обходятся дороже хорошего флагмана.
- Верить бенчмаркам больше, чем собственным прогонам, — бенчмарки измеряют навык в идеальных условиях, а не работу агента в реальной цепочке.
- Сравнивать прайсы, а не стоимость типовой задачи, — дешёвая модель с тремя попытками дороже дорогой с одной.
- Не пересматривать линейку — годовалый «флагман» часто уступает свежей балансовой модели, но и менять модель каждую неделю тоже не стоит.
- Забывать про следование инструкциям — мощная модель, которая «творчески» ломает формат, обходится дороже в ручной правке, чем менее мощная, но послушная.
- Менять модель, не проверив skills и шаблоны, — переиспользуемые элементы курса должны работать на новой модели, иначе вложенный труд пропадает.
Итоги
Решение всегда принимается в паре модель + effort: начинайте с балансовой модели и среднего усилия, переставляйте рычаги по одному и сверяйте результат по логам recorder на реальных задачах. Модель задаёт потолок, контекст даёт факты, а усилия решают, насколько близко к потолку вы подбираетесь, — только в этой связке выбор модели становится инженерным решением.
В следующем уроке перейдём от модели к структуре: разберём субагентов — как использовать независимый контекст для исследовательских задач, чтобы не загрязнять основную сессию.
Глоссарий
- Флагманские модели — самые мощные модели провайдера, нацеленные на максимум качества рассуждения и используемые точечно на сложных задачах.
- Балансовые модели — класс «золотой середины»: дешевле и быстрее флагманов при небольшой потере качества, универсальные рабочие лошадки агента.
- Лёгкие модели — минимальный класс: максимальная скорость и цена, ограниченное рассуждение, ниша — простые массовые задачи.
- Специализированные модели — модели, заточенные под домен (код, математика), дающие качество флагмана в своей нише.
- Контекстное окно — максимальный объём входных токенов, который модель может обработать в одном запросе.
- Бенчмарки — тестовые оценки навыков модели, используемые как грубый фильтр, а не решающий аргумент.
- Следование инструкциям — способность модели точно выполнять требования формата, порядка шагов и ограничений.
- Скорость вывода — количество токенов в секунду, которое модель генерирует под нагрузкой.
- Recorder — инструмент записи запросов между агентом и моделью, используемый для измерения реальной стоимости и качества.
- Связка «модель + effort» — совместный выбор модели и уровня усилий, дающий лучший баланс качества, скорости и цены.