
- Главная
- Искусственный интелект
- Reasoning effort: уровень усилий модели ИИ
Reasoning effort: уровень усилий модели ИИ
Одну и ту же задачу модель может решить двумя способами: мгновенно выдать первое правдоподобное продолжение или сначала долго «обдумать» ответ, перебирая варианты. Разница между этими режимами — уровень усилий рассуждения, параметр reasoning effort. В этом уроке разберём, что это за параметр, как он устроен, как влияет на качество, скорость и стоимость работы ИИ-агента и как выбирать его под конкретную задачу.

Что такое reasoning effort
Механически это связано с тем, как устроены современные LLM. При генерации модель может производить не только итоговый ответ, но и цепочку внутренних рассуждений: промежуточные шаги, проверки, альтернативные формулировки. Параметр усилий определяет, насколько длинной и тщательной может быть эта цепочка и сколько попыток модель сделает, прежде чем остановиться.
Важно не путать усилие с другими параметрами генерации. Это не температура, которая управляет случайностью и «творчеством» ответа. Это не размер контекста и не выбор модели. Усилие — это отдельный рычаг, который регулирует глубину обдумывания при одном и том же контексте и при одной и той же модели.
Ключевой нюанс: высокие усилия не гарантируют правильный ответ.
Они повышают вероятность того, что модель заметит противоречие, перепроверит шаг или откажется от первой пришедшей в голову версии. Но если в контексте нет нужных фактов, усилия лишь помогут модели красиво рассуждать в пустоте — о связи с контекстом поговорим отдельно.
Почему усилия влияют на результат
Первое продолжение — это «самое привычное», самое гладкое по форме. Для простых задач этого достаточно: перефразировать текст, извлечь дату, перевести строку — здесь первое правдоподобное продолжение почти всегда верное.

Но есть класс задач, где первое правдоподобное продолжение систематически ошибочно. Отладка сложного бага, планирование фичи, ревью архитектуры, многошаговые вычисления — тут прямой путь от вопроса к ответу ведёт мимо верного решения. Чтобы попасть в правильный ответ, нужно сделать промежуточные шаги, проверить гипотезу, заметить подвох. Аналогия из жизни: на вопрос «сколько будет два плюс два» мы отвечаем мгновенно, а на «как починить падение сервиса» — сначала рассуждаем, собираем факты, перебираем версии.
Параметр усилий — это как раз регулятор этой «привычки рассуждать». При низком уровне модель ведёт себя как человек, который отвечает не задумываясь: быстро, уверенно, и иногда неверно. При высоком уровне она ведёт себя как человек, который перед ответом проверяет себя: медленнее, дороже по ресурсам, но с меньшим числом глупых ошибок.
Отсюда первый практический вывод: усилия имеют смысл там, где задача действительно требует рассуждения. Применять максимальные усилия к каждой мелочи так же нелепо, как составлять письменный бизнес-план перед тем, как ответить на вопрос «который час».
Уровни усилий на практике
У разных провайдеров набор уровней и их названия могут отличаться, но общая картина одинакова: обычно есть три ступени — низкий, средний и высокий. Некоторые API позволяют задавать и промежуточные значения, но для практики достаточно понимать три базовых режима.
| Уровень | Поведение модели | Типичная цена за ответ |
|---|---|---|
| Низкий | Быстрый ответ без длинного рассуждения, минимальные внутренние шаги | Дёшево, минимум токенов |
| Средний | Умеренная цепочка рассуждений, проверка ключевых шагов | Умеренно, заметный рост токенов |
| Высокий | Развёрнутое рассуждение, перебор альтернатив, самопроверка | Дорого, токенов в разы больше |
Обратите внимание на графу «цена за ответ»: она вырастет не на проценты, а кратно. Усилия буквально покупаются токенами — чем дольше модель рассуждает, тем больше внутреннего текста она производит, и этот текст попадает в платный выход. Поэтому выбор уровня усилий — это всегда компромисс между качеством рассуждения и стоимостью.
Ещё один нюанс: у «рассуждающих» моделей скрытая цепочка рассуждений не показывается пользователю — вы видите только итоговый ответ. Но она существует, потребляет токены и влияет на время ожидания. У обычных моделей усилия проявляются менее контрастно, но направление эффекта то же самое.
Влияние на качество
Список задач, где высокие услилия оправданы, выглядит примерно так: отладка и анализ ошибок, ревью кода и архитектуры, планирование многошаговых изменений, сложные вычисления и логические выводы, генерация сложных запросов к базе данных, разбор непонятного поведения системы.
Но у усилий есть и обратная сторона — переусложнение. Если задача простая, а усилия высокие, модель начинает сомневаться в очевидном, добавлять лишние условия, «улучшать» то, что улучшать не нужно, и в результате может испортить правильный ответ. Знакомый эффект в жизни — эксперт, который превращает простой вопрос в лекцию и в итоге запутывает сам себя.
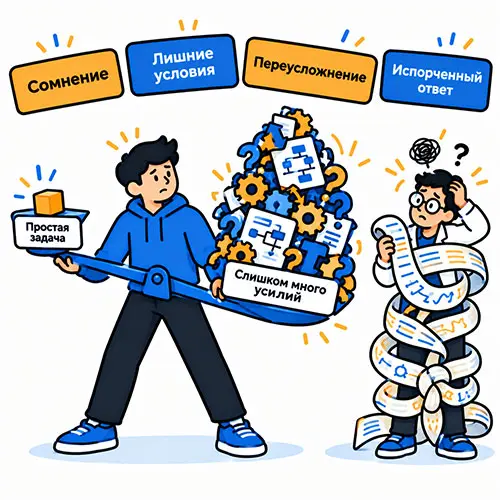
Вывод: зависимость качества от усилий не линейная и не монотонная. Есть зона, где усилия «вытягивают» качество, а за её пределами рост усилий лишь добавляет стоимость и задержку без пользы или даже во вред. Задача инженера — найти границу этой зоны для каждого типа работы.
Влияние на скорость и стоимость
Практический пример: агент разбирает баг. С низким effort он делает пять быстрых попыток, каждая по триста токенов рассуждения, — и, возможно, не находит причину. С высоким effort он делает одну попытку с двумя тысячами токенов рассуждения — и находит её сразу. Второй вариант дороже по токенам, но в итоге дешевле по всей задаче, потому что не тянет за собой повторные циклы, ошибки и новые запросы.
Но работает и обратная логика: если агент гоняет с высоким усилием каждую мелочь — форматирование, переименование, ответ на простой вопрос, — стоимость растёт кратко, а качество не меняется. Дорогое рассуждение на тривиальной задаче — это чистая трата бюджета, которую видно только в логах recorder.
Смотрите не на цену одного запроса, а на цену всей задачи. Сравните в логах recorder две одинаковые задачи с разным effort — вы почти всегда увидите, что «дорогие» усилия окупаются на сложных задачах и не окупаются на простых. Такое сравнение из двух прогонов надёжнее любых общих рекомендаций.
Отдельно про скорость: высокое услилие увеличивает время ответа на секунды и десятки секунд. В интерактивной работе — диалог, быстрые правки — это ощутимо. В длинных автономных циклах агента — почти незаметно, потому что там узкое место всё равно не один запрос, а вся последовательность действий.
Как выбирать уровень усилий
Единого «правильного» значения effort не существует — есть только соответствие уровню сложности задачи. Но выработать рабочую стратегию можно, и она укладывается в несколько простых правил.
- Простые задачи — низкий effort. Перефразирование, извлечение данных, короткие правки, ответы на фактические вопросы. Здесь рассуждение не нужно, а усилия только замедляют ответ и добавляют токены.
- Средние задачи — средний effort. Написание функций средней сложности, объяснение кода, генерация запросов. Умеренная цепочка рассуждений помогает избежать глупых ошибок без переплаты.
- Сложные задачи — высокий effort. Отладка, планирование, ревью, архитектура. Здесь цена рассуждения окупается: одна правильная попытка дешевле трёх быстрых и неверных.
- Неуверенность — повышайте. Если агент с низким effort ошибся дважды подряд на одной и той же задаче, это сигнал повысить уровень, а не повторять тот же запрос в третий раз.
- Экспериментируйте с парой «модель + effort». Вместо того чтобы искать самую дорогую модель, попробуйте более скромную модель с высоким effort — иногда комбинация даёт качество флагмана за меньшие деньги.
Главная мысль этой стратегии: effort — это второй рычаг управления качеством, который есть у вас помимо выбора модели. Модель задаёт потолок возможностей, а усилия решают, насколько близко к этому потолку вы подбираетесь на каждой конкретной задаче. Правильная пара «модель + усилия» часто важнее, чем просто «самая мощная модель».
Усилие и контекст
С одной стороны, усилия не заменяют контекст. Из урока 16 мы знаем: если в контексте нет фактов, модель галлюцинирует — и высокий effort не спасёт, а иногда усугубит ситуацию, потому что модель «уверенно рассуждает» на основе вымысла, выстраивая вокруг него правдоподобные цепочки. Рассуждение работает только на реальных данных: файлах, выводах команд, документации.
С другой стороны, качественный контекст снижает потребность в высоких усилиях. Когда нужные факты уже лежат перед моделью, ответ часто очевиден — и среднего, а то и низкого effort достаточно. Знакомая закономерность из урока 13: чем лучше вы подготовили контекст, тем меньше модель должна «додумывать», а значит, тем меньше ей нужно усилий.
Из этого следует практический приём: прежде чем повышать effort, проверьте контекст. Часто проблема не в том, что модель «мало думает», а в том, что ей не на что опереться. Сначала дайте факты, потом уже добавляйте усилия — в таком порядке рычаги работают максимально эффективно, и бюджет не тратится впустую.
Сделайте правило «сначала контекст, потом усилия». Если агент дал неверный ответ — спросите себя: ему не хватало фактов или глубины рассуждения? В первом случае добавьте в контекст файлы и выводы команд, во втором — поднимите effort. Перепутав рычаги, вы либо переплатите за токены, либо так и не получите верный ответ.
Где настраивается усилие
Важно понимать: конкретные названия и расположение настроек у разных инструментов отличаются, и курс сознательно не привязывается к одному из них. Принцип один: ищите параметр, управляющий глубиной рассуждения, — и вы найдёте effort под тем или иным именем. Меняется он одинаково: значение для простых задач ниже, для сложных выше.
Ещё один нюанс: не все модели поддерживают управление усилиями. У некоторых «рассуждающих» моделей уровень фиксирован или управляется косвенно. Проверьте возможности своей модели и провайдера заранее — это сэкономит время на поиске несуществующей настройки.
Типичные ошибки
- Ставить максимальный effort на все задачи подряд — качество на простых задачах не вырастет, а стоимость и задержки вырастут кратно.
- Ожидать, что усилия заменят качественный контекст, — без фактов модель рассуждает над вымыслом, и высокий effort лишь делает галлюцинации убедительнее.
- Не смотреть в логи recorder при смене effort — без цифр невозможно понять, окупаются ли дополнительные токены улучшением результата.
- Игнорировать overthinking — на простых задачах высокие усилия могут испортить правильный ответ лишними сомнениями и «улучшениями».
- Повторять один и тот же запрос с тем же effort вместо того, чтобы повысить уровень после второй неудачи.
- Считать effort заменой выбору модели — это разные рычаги: модель задаёт потолок, усилия приближают к нему, и работают они в паре, а не вместо друг друга.
Итоги
Работает он в паре с контекстом и выбором модели: сначала дайте агенту факты, затем подберите уровень усилий под сложность задачи, и только потом думайте о более мощной модели. Осознанное управление этими тремя рычагами — контекст, усилия, модель — и есть суть инженерной работы с ИИ-агентом.
В следующем уроке углубимся в выбор модели: разберём, чем отличаются модели для разных задач и по каким критериям выбирать их в паре с уровнем усилий.
Глоссарий
- Reasoning effort — параметр, управляющий глубиной рассуждения модели перед ответом.
- Chain of thought — цепочка внутренних шагов рассуждения, которую модель производит при генерации ответа.
- Токены рассуждения — токены, расходуемые моделью на внутреннее обдумывание, которые попадают в платный выход.
- Overthinking — переусложнение: избыточное рассуждение, ухудшающее ответ на простых задачах.
- Температура — параметр случайности генерации, который не следует путать с effort.
- Латентность — время ожидания ответа модели, растущее с увеличением усилий.
- Recorder — инструмент записи запросов между агентом и моделью, используемый для оценки стоимости усилий.
- Smart Zone — состояние умеренно заполненного контекста, в котором рассуждение модели работает в полную силу.
- Dumb Zone — состояние переполненного контекста, в котором качество рассуждения деградирует независимо от усилий.